

Destacados
Investigador en aprendizaje profundo, ingeniero de redes neuronales, ingeniero de entrenamiento distribuido, científico en aprendizaje profundo, arquitecto de modelos de IA, ingeniero de entrenamiento a gran escala, ingeniero de investigación en aprendizaje profundo, ingeniero de computación en GPU, ingeniero de arquitectura neuronal, científico en aprendizaje profundo aplicado
Los modelos que están detrás de los generadores de imágenes que crean arte a partir de una oración, los chatbots que mantienen conversaciones reales, los sistemas que predicen cómo se pliegan las proteínas y los autos que reconocen la carretera que tienen por delante tienen algo en común: enormes redes neuronales entrenadas en racks de GPU que funcionan durante días o semanas seguidas. Diseñar esas redes y controlar ese proceso de entrenamiento, para que realmente se complete y funcione, es el trabajo del ingeniero de aprendizaje profundo.
Los ingenieros de aprendizaje profundo se enfocan en la arquitectura y el entrenamiento de redes neuronales a gran escala, un enfoque diferente al de los ingenieros que implementan modelos ya terminados en los productos. Diseñan y crean prototipos de nuevas estructuras de redes, ejecutan tareas de entrenamiento distribuidas entre docenas o cientos de GPUs y depuran problemas que solo surgen a gran escala, como una sesión de entrenamiento que se detiene misteriosamente o un valor de pérdida que se dispara de repente. Trabajan en estrecha colaboración con científicos de investigación que proponen nuevas ideas, ingenieros de infraestructura que administran el hardware y equipos de hardware que optimizan los chips en los que todo funciona.
Mediante el uso de marcos como PyTorch, TensorFlow o JAX, la programación de GPU con CUDA y herramientas de entrenamiento distribuido como DeepSpeed, Megatron-LM y Ray, los ingenieros de aprendizaje profundo convierten una idea prometedora en un modelo que realmente se entrena con éxito y de manera eficiente. Su trabajo determina si los modelos de IA más ambiciosos son siquiera posibles y si entrenarlos cuesta una cantidad razonable o una fortuna desmesurada, lo que los convierte en elementos esenciales para casi todos los avances importantes en la IA moderna.
- Trabajar en la vanguardia tecnológica que hace posible el desarrollo de los modelos de IA más grandes y potentes
- Resolver retos de ingeniería complejos que combinan conocimientos de matemáticas, sistemas y hardware
- Ser de los primeros en ver cómo una arquitectura completamente nueva funciona realmente a gran escala
- Contribuir directamente a los avances que marcarán el rumbo de la tecnología en los próximos años
Horario de trabajo
La mayoría de los ingenieros de aprendizaje profundo trabajan a tiempo completo, aunque el horario a menudo se adapta a los procesos de entrenamiento de larga duración que deben supervisarse, a veces durante la noche o el fin de semana, ya que un proceso de entrenamiento de varias semanas no puede simplemente pausarse y reanudarse cuando sea conveniente. El trabajo se realiza en gran medida en computadora y se divide entre escribir y revisar código, analizar registros y métricas de entrenamiento, y colaborar con equipos de investigación e infraestructura. La mayoría de los ingenieros de aprendizaje profundo trabajan en laboratorios de investigación de IA, grandes empresas tecnológicas o startups bien financiadas que desarrollan modelos de vanguardia, ya que este trabajo requiere importantes recursos computacionales.
Funciones típicas
- Diseño y creación de prototipos de nuevas arquitecturas de redes neuronales
- Ejecutar y supervisar trabajos de entrenamiento distribuidos a gran escala en numerosas GPU o TPU
- Depuración de inestabilidades en el entrenamiento, como picos de pérdida, gradientes que desaparecen o se disparan, y fallas de hardware
- Optimización del código del modelo para mejorar la velocidad y la eficiencia de memoria
- Implementación de técnicas como el entrenamiento con precisión mixta y el checkpointing de gradientes
- Comparación de nuevas arquitecturas con los puntos de referencia existentes
- Ajuste de hiperparámetros a gran escala en sesiones de entrenamiento prolongadas
- Colaboración con ingenieros de hardware e infraestructura en materia de eficiencia computacional
- Leer y poner en práctica las técnicas descritas en artículos de investigación publicados recientemente
- Desarrollo de herramientas y scripts internos para acelerar la experimentación
- Documentar los resultados de los experimentos y compartir los hallazgos con los equipos de investigación
Responsabilidades adicionales
- Gestión y previsión de los presupuestos de recursos computacionales en múltiples ejecuciones de entrenamiento
- Orientar a los ingenieros en formación y a los pasantes de investigación sobre técnicas de capacitación
- Contribuir al desarrollo de marcos y herramientas internas de aprendizaje profundo
- Mantenerse al día en un campo de investigación en el que se publican nuevos resultados casi cada semana
- Participar en revisiones de código y arquitectura
- De vez en cuando, publicar los resultados en informes internos o artículos externos
El día de un ingeniero de aprendizaje profundo suele comenzar revisando los trabajos de entrenamiento que se ejecutaron durante la noche, analizando las curvas de pérdida y las métricas para verificar si una ejecución avanza con normalidad o si ha surgido algún problema, como un proceso atascado o un pico de errores. Si algo parece estar mal, las primeras horas pueden convertirse en una sesión de depuración exhaustiva que abarca el código, los datos y los registros de hardware.
Por lo general, dedicamos el mediodía a desarrollar y experimentar, ya sea implementando una nueva idea arquitectónica, ajustando un script de entrenamiento para aprovechar mejor la GPU o resolviendo un error sutil que solo aparece cuando el entrenamiento se distribuye entre varias máquinas. A menudo tenemos conversaciones con los investigadores sobre lo que podría significar un nuevo resultado, o con los ingenieros de infraestructura sobre cómo sacar más rendimiento de un hardware limitado.
Las tardes suelen dedicarse a iniciar nuevos experimentos, revisar los resultados de ejecuciones anteriores y actualizar la documentación para que todo el equipo pueda aprender de lo que funcionó y de lo que no. Dado que las ejecuciones de entrenamiento pueden tardar días, gran parte del trabajo consiste en planificar los siguientes pasos de manera inteligente y luego analizar con paciencia y cuidado los resultados obtenidos, en lugar de esperar respuestas inmediatas.
Habilidades interpersonales
- Una profunda curiosidad por saber cómo y por qué aprenden las redes neuronales
- Se siente cómodo con la ambigüedad y la experimentación constante
- Resiliencia cuando los experimentos fallan, lo cual ocurre con frecuencia en este campo
- Gran capacidad de razonamiento analítico y matemático
- Paciencia durante las carreras largas de entrenamiento que tardan días en completarse
- Sólida colaboración con los equipos de infraestructura e investigación
- Redacción técnica clara para documentar experimentos y resultados
- Atención al detalle en el código que se ejecuta a gran escala
- Perseverancia a través de repetidas rondas de depuración
- Capacidad de adaptación a nuevos marcos, hardware y técnicas
- Pensamiento tranquilo y metódico bajo presión, ya que el procesamiento de datos es costoso y los errores suponen un gasto real de dinero
Habilidades técnicas
- PyTorch, TensorFlow o JAX para desarrollar y entrenar redes neuronales profundas
- Programación con CUDA y GPU para código en el que el rendimiento es fundamental
- Marcos de entrenamiento distribuido como DeepSpeed, Megatron-LM, Horovod o Ray
- Álgebra lineal y cálculo para comprender la optimización y la retropropagación
- Computación de alto rendimiento y herramientas de programación de clústeres como Slurm o Kubernetes
- Herramientas de perfilado y depuración del rendimiento para identificar cuellos de botella
- Técnicas de entrenamiento de precisión mixta y con uso eficiente de la memoria
- Git para el control de versiones y herramientas como Weights & Biases o MLflow para el seguimiento de experimentos
- Python y, en ocasiones, C++ para el código en el que el rendimiento es fundamental
- Estadística y probabilidad para comprender el comportamiento de los modelos y su evaluación
- Ingeniero de arquitectura de modelos: diseña y crea prototipos de nuevas estructuras de redes neuronales
- Ingeniero de capacitación en sistemas y entornos distribuidos: Se enfoca en ampliar la capacitación de manera eficiente a través de múltiples máquinas
- Ingeniero de aprendizaje automático con conocimiento de hardware: optimiza modelos específicamente para GPU, TPU o chips de IA personalizados
- Ingeniero de modelos generativos: se enfoca en el entrenamiento de modelos que generan imágenes, texto, audio o video
- Ingeniero de aprendizaje por refuerzo: Entrena modelos que aprenden a través de la prueba, el error y la recompensa
- Ingeniero de investigación en escalabilidad: Estudia cómo cambia el desempeño de los modelos a medida que aumentan el tamaño y el volumen de datos
- Ingeniero de eficiencia y compresión: se enfoca en hacer que los modelos grandes sean más pequeños, más rápidos y más económicos de ejecutar
- Laboratorios de investigación en inteligencia artificial y desarrolladores de modelos de vanguardia
- Grandes empresas tecnológicas con divisiones dedicadas a la investigación en inteligencia artificial
- Proveedores de computación en la nube que desarrollan infraestructura y servicios de inteligencia artificial
- Startups de IA con buena financiación que desarrollan modelos a gran escala
- Empresas de semiconductores y hardware que fabrican chips de inteligencia artificial
- Empresas de vehículos autónomos y robótica
- Instituciones de investigación científica que utilizan el aprendizaje profundo para la investigación
- Organismos de investigación gubernamentales y laboratorios nacionales
- Universidades con sólidos programas de investigación en aprendizaje profundo
- Empresas de tecnología financiera que utilizan modelos predictivos a gran escala
- Empresas del sector de la salud y la biotecnología que aplican el aprendizaje profundo a la investigación
- Organizaciones del sector de la defensa y aeroespacial que investigan sistemas avanzados de inteligencia artificial
Los ingenieros de aprendizaje profundo trabajan con recursos computacionales que son a la vez escasos y costosos, por lo que una sesión de entrenamiento fallida de varias semanas no solo representa una pérdida de tiempo, sino también una pérdida considerable de dinero. Esa realidad genera una presión real para planificar los experimentos con cuidado y detectar los problemas lo antes posible, y los errores pueden parecer de alto riesgo de una manera que no ocurre en proyectos de programación a menor escala.
El trabajo suele implicar jornadas largas y, a veces, impredecibles, especialmente cuando hay que supervisar una prueba de entrenamiento fuera del horario laboral habitual o cuando se acerca la fecha límite de lanzamiento. Esperar días para obtener resultados, solo para descubrir un error sutil que obliga a empezar de cero, es una parte normal y, a veces, agotadora del trabajo.
Este campo es sumamente competitivo y avanza a un ritmo agotador, con nuevos artículos, técnicas y pruebas de referencia que surgen constantemente. Para mantenerse al día, es necesario aprender casi constantemente, y la sensación de que «todos los demás avanzan más rápido» es un sentimiento común y, a veces, estresante en este ámbito de la IA.
- Las leyes de escala siguen guiando el desarrollo de modelos cada vez más grandes
- Desarrollo de arquitecturas de «mezcla de expertos» que activan solo partes de un modelo a la vez
- Una mayor adopción de técnicas eficientes de ajuste fino, como LoRA y la cuantificación
- El uso cada vez mayor de hardware especializado en inteligencia artificial, incluyendo chips personalizados y TPU
- El uso cada vez mayor de datos sintéticos para complementar o sustituir los escasos datos de entrenamiento del mundo real
- Avances en la dispersión y la compresión de modelos para reducir los costos de entrenamiento e inferencia
- El rápido crecimiento de los modelos base multimodales entrenados conjuntamente con texto, imágenes y audio
- La tendencia al alza de las publicaciones de modelos de peso abierto está redefiniendo quién puede realizar investigación de vanguardia
- Cada vez se presta más atención al consumo de energía y al costo ambiental de los entrenamientos a gran escala
- La creciente colaboración entre los ingenieros de aprendizaje profundo y los diseñadores de chips de hardware
Muchos ingenieros de aprendizaje profundo crecieron apasionados por las competencias de matemáticas, los retos de programación y el montaje o la mejora de sus propias computadoras. Les atraían los sistemas con muchas piezas móviles, ya fuera modificar un videojuego, hacer overclocking a una PC para videojuegos o escribir scripts para automatizar tareas tediosas.
Otros encontraron su pasión en las clases de física y matemáticas avanzadas, disfrutando del reto que representaban los problemas que requerían verdadera perseverancia para resolverlos. La fascinación tanto por la teoría que explica cómo funcionan las cosas como por los experimentos prácticos necesarios para hacerlas funcionar a menudo los llevó directamente a una carrera dedicada a entrenar las redes neuronales más grandes del mundo.
La mayoría de los ingenieros de aprendizaje profundo cuentan con, al menos, una licenciatura en informática, matemáticas, física o ingeniería eléctrica, y muchos puestos, especialmente en laboratorios centrados en la investigación, dan preferencia a los candidatos con una maestría o un doctorado. Lo que distingue a los candidatos exitosos son unos sólidos fundamentos matemáticos y la experiencia práctica en el entrenamiento de modelos reales, no solo en el estudio de la teoría.
Los estudiantes pueden cursar materias relacionadas con temas como:
- Álgebra lineal
- Cálculo multivariable
- Probabilidad y estadística
- Aprendizaje profundo
- Computación paralela y distribuida
- Arquitectura de computadoras
- Teoría de la optimización
- Estructuras de datos y algoritmos
- Aprendizaje automático
- Métodos numéricos
Dado que este campo requiere un uso intensivo de recursos computacionales, es esencial contar con experiencia práctica en el entrenamiento de modelos reales, incluso los más pequeños, en hardware real. Realizar cursos de aprendizaje profundo de código abierto, reproducir los resultados de artículos publicados y experimentar con el entrenamiento distribuido en GPU en la nube les brinda a los estudiantes una ventaja real que un expediente académico por sí solo no puede demostrar.
- Toma cursos de matemáticas que abarquen desde el cálculo hasta el álgebra lineal y la estadística, y sigue avanzando cada vez más
- Aprende a programar en Python y crea pequeños proyectos con los que entrenar modelos reales
- Únete a un equipo de matemáticas, a un club de programación o a un grupo de programación competitiva
- Arma o actualiza tu propia computadora para comprender los conceptos básicos del hardware
- Toma un curso gratuito en línea sobre aprendizaje profundo para sentar unas bases sólidas desde el principio
- Participa en hackatones o concursos relacionados con el aprendizaje automático o la inteligencia artificial
- Intenta reproducir los resultados de un artículo de investigación muy conocido a pequeña escala
- Estudia física, especialmente temas relacionados con la optimización y los sistemas
- Aprende los conceptos básicos de la computación en la nube entrenando un modelo en una GPU en la nube
- Lee artículos de investigación, aunque al principio solo entiendas algunas partes
- Busca pasantías u oportunidades de investigación relacionadas con el aprendizaje automático
- Habla con ingenieros o investigadores especializados en aprendizaje profundo sobre en qué consiste realmente su trabajo
- Sólida formación en matemáticas avanzadas, especialmente en álgebra lineal y cálculo
- Acceso a hardware moderno de GPU para proyectos prácticos de aprendizaje profundo
- Docentes con experiencia activa en investigación o en el sector empresarial en el ámbito del aprendizaje profundo
- Cursos que van más allá del uso de modelos predefinidos para, de hecho, entrenar redes desde cero
- Un proyecto final o de investigación que incluya el entrenamiento y la evaluación de modelos reales
- Experiencia en computación distribuida y sistemas a gran escala, no solo en programación en una sola máquina
- Fuertes vínculos con pasantías o puestos de investigación en laboratorios de inteligencia artificial o empresas tecnológicas
- Oportunidades para leer y reproducir artículos de investigación como parte de las tareas del curso
- Servicios de orientación profesional o asesores que conozcan las carreras profesionales en el ámbito de la investigación sobre el aprendizaje profundo
- Una comunidad de investigación o un laboratorio activo al que puedas unirte mientras cursas la licenciatura
- Apoyo para cursar estudios de posgrado si deseas profundizar en la investigación
- Un plan de estudios actualizado que se adapta a un campo que evoluciona a un ritmo extremadamente rápido
- Arma un portafolio de proyectos en los que hayas entrenado modelos de verdad, no solo hayas usado modelos preentrenados
- Reproduce los resultados de un artículo publicado y documenta tu proceso de manera pública
- Postúlate para puestos de nivel inicial, como ingeniero de aprendizaje automático, ingeniero de investigación o ingeniero de aprendizaje profundo
- Contribuye a los marcos de aprendizaje profundo de código abierto o al código de investigación
- Participa en concursos de aprendizaje automático que impliquen el entrenamiento de modelos reales
- Busca pasantías de investigación en laboratorios de inteligencia artificial, universidades o empresas tecnológicas
- Practica cómo explicar una sesión de entrenamiento que hayas realizado, incluyendo qué salió mal y cómo lo identificaste.
- Establece contactos con investigadores e ingenieros en conferencias como NeurIPS o ICML
- Prepárate para entrevistas técnicas que abarcan matemáticas, sistemas y conceptos básicos del aprendizaje profundo
- Destaca cualquier experiencia que tengas en computación distribuida o entrenamiento a gran escala, incluso en proyectos escolares
- Considera cursar una maestría o un doctorado si quieres trabajar en los laboratorios más dedicados a la investigación.
- Muéstrate dispuesto a empezar en un equipo de aprendizaje automático más amplio para adquirir experiencia relevante
- A medida que adquieras experiencia, asume la responsabilidad de proyectos de capacitación más grandes y ambiciosos
- Desarrollar un historial de éxito en el entrenamiento de modelos que cumplan con objetivos de desempeño exigentes
- Adquiere conocimientos profundos en un área especializada, como los sistemas distribuidos, la eficiencia o el diseño de arquitecturas
- Orientar a los ingenieros en formación y a los pasantes de investigación sobre técnicas de capacitación
- Colaborar en publicaciones, patentes o comunicados públicos de investigación
- Establecer relaciones sólidas con los equipos de infraestructura y hardware
- Mantente al día con las nuevas arquitecturas y técnicas, ya que este campo evoluciona cada semana
- Ascender a puestos de ingeniero de investigación sénior, ingeniero principal o jefe de investigación
Sitios web:
- Artículos con código - paperswithcode.com
- arXiv (cs.LG) - arxiv.org/list/cs.LG/recent
- NeurIPS - neurips.cc
- ICML - icml.cc
- Distill.pub - distill.pub
- Hugging Face - huggingface.co
- Documentación de DeepSpeed - deepspeed.ai
- Tutoriales de PyTorch - pytorch.org/tutorials
- Blog de Weights & Biases - wandb.ai/fully-connected
- Lil'Log, de Lilian Weng - lilianweng.github.io
- Blog de Google DeepMind - deepmind.google
- Aprendizaje profundo full stack - fullstackdeeplearning.com
Libros:
- Aprendizaje profundo, de Ian Goodfellow, Yoshua Bengio y Aaron Courville
- «Sumérgete en el aprendizaje profundo», de Aston Zhang, Zachary C. Lipton, Mu Li y Alexander J. Smola
- Aprendizaje profundo para programadores con fastai y PyTorch, de Jeremy Howard y Sylvain Gugger
- Los principios de la teoría del aprendizaje profundo, de Daniel A. Roberts y Sho Yaida
- • «Aprendizaje profundo eficiente», de Gaurav Menghani y Naresh Singh
Si descubres que la carrera de ingeniero en aprendizaje profundo no es lo que buscas, tus habilidades en matemáticas, pensamiento sistémico y programación a gran escala se pueden aplicar fácilmente a muchas profesiones relacionadas.
- Ingeniero de aprendizaje automático
- Investigador científico en inteligencia artificial
- Científico de datos
- Ingeniero en computación de alto rendimiento
- Ingeniero en visión computacional
- Ingeniero de software
- Ingeniero en robótica
- Investigador cuantitativo
- Ingeniero de sistemas
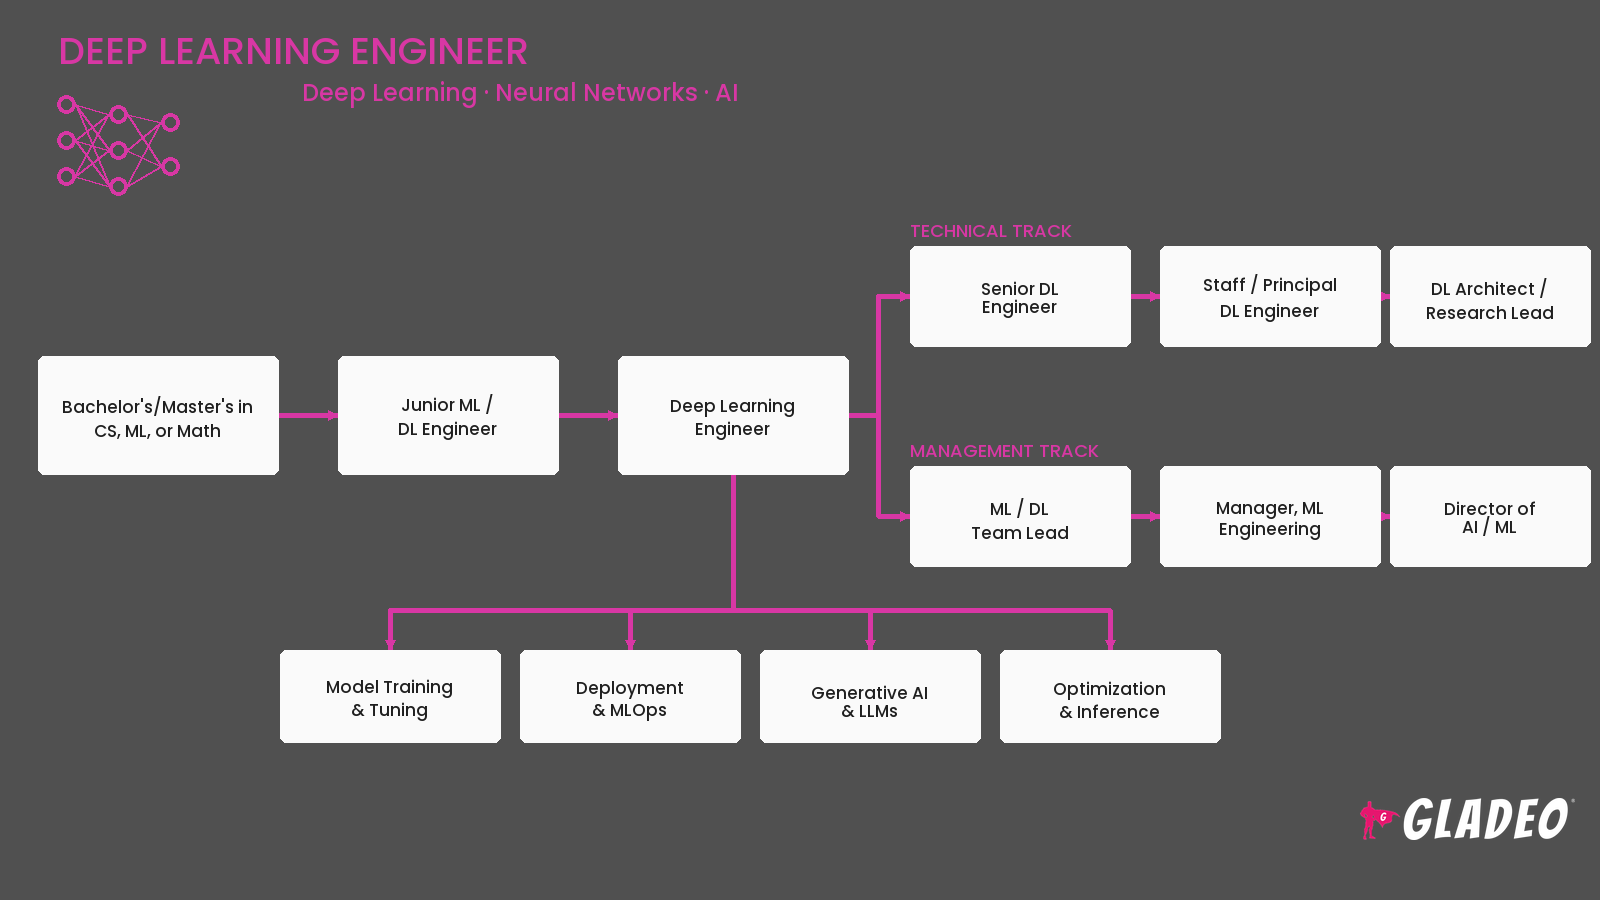
Haz clic aquí para descargar la infografía
Noticias
Empleos destacados
Cursos y herramientas en línea